2026年企业级GPU排名:H200 NVL、RTX PRO 6000等PCIe AI加速卡实测对比
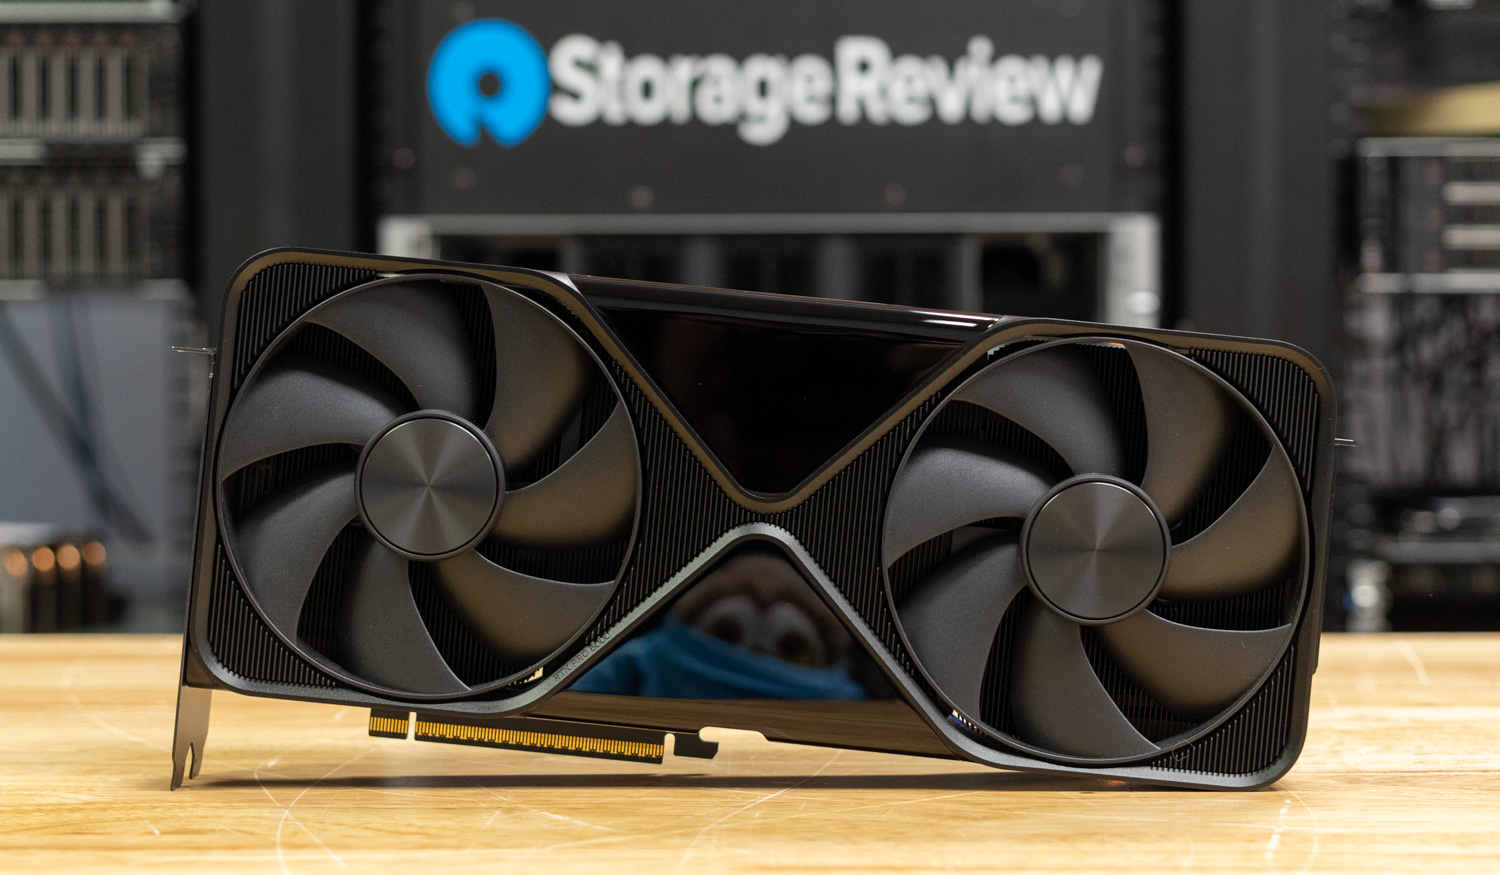
根据知名硬件评测机构StorageReview发布的2026年企业GPU指南,五款主流PCIe AI加速卡在统一vLLM测试栈下完成了吞吐量对决。测试覆盖从72W到600W功耗范围、24GB到141GB显存容量的各层级产品,最终NVIDIA H200 NVL凭借141GB HBM3e和4.8TB/s带宽夺得整体最佳,而RTX PRO 6000 Blackwell Server Edition则以96GB GDDR7和广泛功能成为企业推理首选。下文基于StorageReview实验室实测数据,按显存层级与功耗需求逐一解析每款显卡的表现。
封杀艺人测试方法与排名依据
StorageReview在Dell PowerEdge R770服务器上,使用NVIDIA NGC vLLM 26.08容器(vLLM 0.27.1 on CUDA 13.4.1)及595.71.05驱动,对每张卡进行1至32并发流(H200/H100最高128流)的在线推理测试。模型包括 Ministral 3 14B FP8、8B及3B变体,涵盖512输入/512输出短上下文和8192输入/1024输出长文档形状。存储评测实验室强调,所有被测卡均为单张PCIe插槽形态,测试结果代表数据中心主流配置的实际性能。排名不仅基于峰值吞吐量,还考察不同并发度下的稳定性,最终排序在全部模型和请求形状上保持一致。
明星道歉
H200 NVL:内存与带宽的统治力
NVIDIA H200 NVL搭载141GB HBM3e显存,带宽达4.8TB/s,在32并发流下对Ministral 3 14B FP8模型输出3435 tok/s,较H100 NVL的3096 tok/s提升约11%,较RTX PRO 6000的2283 tok/s高出50%。在128流时差距进一步拉大至7336 tok/s,而RTX卡已无法继续扩展。长文档场景下,H200 NVL以1038 tok/s领先RTX PRO 6000的608 tok/s,优势达71%。StorageReview指出,该卡在450W(PowerEdge R770 GPU槽最大供电)下测试,其额定600W未经验证,因此当前数据为性能下限。唯一的短板是FP4模型(Qwen3.8-27B)因缺乏硬件支持,vLLM需反量化,速率仅467 tok/s,落后于RTX PRO 6000的616 tok/s。H200 NVL还支持900GB/s NVLink桥接,是多卡部署70B-120B参数模型的首选。
道歉声明RTX PRO 6000:功能最全的企业推理GPU
RTX PRO 6000 Blackwell Server Edition配备96GB GDDR7 ECC显存,带宽1.6TB/s,600W功耗下在短上下文测试中输出2283 tok/s(14B FP8模型),约为RTX PRO 4500的两倍。长文档场景下,其96GB大容量确保32并发流性能不衰减,而32GB/48GB卡在此处已见顶。StorageReview特别测试了450W功耗限制下的表现:短上下文仅下降2-5%,长上下文下降4-9%,FP8 FP8 MAMF TFLOPS不受影响。这意味着在2U服务器中,将其限制在450W可大幅提升能效比(每瓦4.8 tok/s vs 3.8 tok/s)。除推理外,该卡独有RT核心、4个编码器/解码器及显示输出,可同时承担渲染、转码或虚拟工作站任务。NVIDIA官方将Server Edition功耗定为600W,与Workstation Edition一致,被动散热版适合高密度部署。
律师声明
L40S、RTX PRO 4500与L4:不同层级的可靠选择
L40S以48GB GDDR6和350W功耗,在14B FP8模型32流下输出995 tok/s,文档形状230 tok/s,是仍在量产的主流推理卡,适合预算有限的中等模型部署。RTX PRO 4500 Blackwell Server Edition单槽165W设计,32GB GDDR7提供1107 tok/s(短上下文),但文档形状仅为190 tok/s,显存成为瓶颈。它适合小模型或低并发场景。L4为72W单槽半高卡,24GB GDDR6,364 tok/s(短)和42 tok/s(长),专为边缘推理和1U服务器打造。StorageReview测试显示,L40S在MAMF FP8 TFLOPS上达369,RTX PRO 4500为280,L4为116,三者性能随功耗和显存等级线性差异。
性能对比一览
| 类别 | 加速卡 | 显存/带宽 | 插槽/实测功耗 | 短上下文14B (tok/s) | 长文档8K (tok/s) | MAMF FP8 (TFLOPS) | 完整评测 |
|---|
| --- | --- | --- | --- | --- | --- | --- | --- |
|---|
| 最佳总体PCIe AI加速器 | NVIDIA H200 NVL | 141GB HBM3e / 4.8TB/s | 双槽 / 450W* | 3,435 | 1,038 | 1,262 | [ASUS ET900N G3评测](https://www.storagereview.com/review/asus-expertcenter-pro-et900n-g3-review) |
|---|
| 最佳企业推理GPU | NVIDIA RTX PRO 6000 Blackwell Server Edition | 96GB GDDR7 / 1.6TB/s | 双槽 / 600W (450W亦可) | 2,283 | 608 | 774 | [RTX PRO 6000评测](https://www.storagereview.com/review/nvidia-rtx-pro-6000-workstation-gpu-review-blackwell-architecture-and-96-gb-for-pro-workflows) |
|---|
| 最佳单槽GPU | NVIDIA RTX PRO 4500 Blackwell Server Edition | 32GB GDDR7 / 800GB/s | 单槽 / 165W | 1,107 | 190 | 280 | [RTX PRO 4500 SE评测](https://www.storagereview.com/review/nvidia-rtx-pro-4500-blackwell-server-edition-review) |
|---|
| 最佳主流推理卡(在产) | NVIDIA L40S | 48GB GDDR6 / 864GB/s | 双槽 / 350W | 995 | 230 | 369 | [L40S数据同上] |
|---|
| 最佳插槽供电卡(1U/边缘) | NVIDIA L4 | 24GB GDDR6 / 300GB/s | 单槽HHHL / 72W | 364 | 42 | 116 | [L4评测](https://www.storagereview.com/review/nvidia-l4-gpu-review-low-power-inferencing-wizard) |
|---|
*注:H200 NVL在Dell PowerEdge R770 GPU槽最大450W下测试,额定600W未验证。

常见问题解答
Q1: H200 NVL与RTX PRO 6000应如何选择?
A1: 两者目标场景不同。H200 NVL拥有141GB HBM3e和4.8TB/s带宽,在70B-120B参数模型、需要高并发和NVLink多卡扩展时占据绝对优势。RTX PRO 6000以96GB GDDR7提供出色的推理性能,且支持RT核心、编码器及vGPU,适合推理为主同时需要渲染或虚拟GPU的工作负载。若预算允许且追求纯推理极限,选H200;若需要灵活多功能,选RTX PRO 6000。
Q2: 450W功耗限制对RTX PRO 6000影响有多大?
A2: StorageReview测试表明,在450W cap下,该卡短上下文性能仅下降2-5%,长上下文下降4-9%,FP8浮点性能几乎不变。对于2U服务器机箱,若供电有限,将功耗限制在450W几乎不损失推理吞吐,且能效比提升约26%(4.8 tok/s/W vs 3.8 tok/s/W)。购买时可根据服务器电源余量灵活配置。
展望AI推理硬件趋势
2026年企业级GPU市场显存容量与带宽成为核心差异化因素。H200 NVL展示了HBM3e对大规模模型的独特价值,而RTX PRO 6000证明了GDDR7在合理功耗下足够胜任大部分推理任务。随着Blackwell架构普及和FP4硬件成熟,未来PCIe加速卡将进一步提升能效与吞吐量。对于数据中心运营商,选择应基于实际模型大小、并发需求及机箱功耗限制,而非单纯追逐峰值TFLOPS。